Que vaut la note des comptes ?
Échantillon, estimations et limites de la note de l’onglet Synthèse, présentés comme une sortie de logiciel statistique.
Les données
La note est recalculée pour chaque société et chaque exercice de 2021 à 2024, avec les seuls comptes connus à la fin de l’exercice et le cours du 30 juin suivant (date supposée de publication des comptes). On observe ensuite ce qui se passe l’exercice d’après.
Sociétés                                  48   dont banques 16
Exercices                                 2021, 2022, 2023, 2024
Observations (société × exercice)         192   (2021 : 48 ; 2022 : 48 ; 2023 : 48 ; 2024 : 48)
Note : moyenne ; sd.                      59,8 ; 17,7

Observations disponibles selon le résultat étudié
  rentabilité N+1                         179
  évolution du bénéfice (log)             161
  baisse du dividende                     129
  rendement du cours à 6 / 12 mois        178 / 176

Critère croissance disponible : 2021 : 1 ; 2022 : 3 ; 2023 : 48 ; 2024 : 48
La croissance exige trois exercices de comptes : les notes de 2021 et 2022 sont calculées sans elle, celles de 2023 et 2024 avec les cinq critères.
L’estimation
Estimateur : moindres carrés ordinaires (MCO) sur un panel société × exercice, avec une constante par année (effets fixes d’année). Ce n’est ni une méthode des moments généralisée ni un modèle à effets fixes de société : avec quatre exercices et une note qui change peu d’une année à l’autre, des effets fixes de société absorberaient presque toute l’information.
Erreurs standard : robustes, groupées par société (estimateur CR1), loi de Student à G − 1 degrés de liberté. Avec 38 à 48 groupes, c’est à la limite de ce que cette correction supporte : nous ajoutons donc un bootstrap sauvage par grappes (poids de Webb, hypothèse nulle imposée, 9 999 tirages), plus fiable quand les groupes sont peu nombreux, et un test de permutation sans hypothèse de loi.
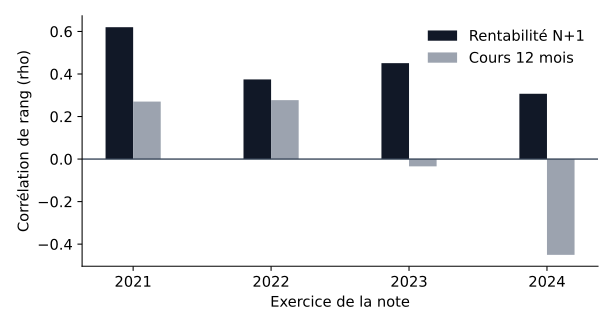
Cours : les rendements bougent ensemble d’une année à l’autre. La méthode de Fama-MacBeth (une régression par année, moyenne des pentes) y est adaptée, mais n’a que 3 degrés de liberté ici. Variable binaire (baisse du dividende) : modèle de probabilité linéaire, faute de données pour un logit stable. Tests multiples : correction de Holm sur les quatre résultats principaux, appliquée aux p du bootstrap. Rentabilités et rendements sont ramenés entre leurs 2,5 % et 97,5 %.
Est-ce solide avec si peu de données ? Pour les estimations, oui avec réserves : les MCO sont sans biais si le modèle est bien spécifié, et le bootstrap corrige le risque principal (erreurs trop petites). Pour la puissance, non : 179 observations pour 48 sociétés ne permettent de repérer que des effets nets. Un résultat « non significatif » veut dire « on ne sait pas », pas « il n’y a rien ». Autre risque propre à ce test : la note et le résultat viennent des mêmes comptes (la rentabilité est dans la note et dans ce qu’on cherche à prédire), d’où le modèle avec contrôle plus bas.
Résultats
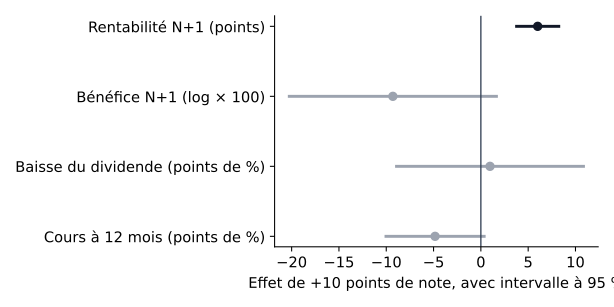
Chaque coefficient se lit comme l’effet d’une hausse de 10 points de la note. Colonnes 2 à 4 : coefficients multipliés par 100.
                                    (1)          (2)          (3)          (4)
Variable à expliquer          roe_suiv.    ln bénéf.  div. baisse   cours 12 m
──────────────────────────────────────────────────────────────────────────────
note (+10 points)                  6,01        −9,30         0,97        −4,84
  Sd.                            (1,11)       (5,42)       (4,87)       (2,58)
  t                                5,43        −1,72         0,20        −1,88
  P>|t|                           0,000        0,094        0,844        0,067
  p bootstrap (grappes)           0,000        0,113        0,851        0,089
  p Holm                          0,001        0,267        0,851        0,267
  p permutation                   0,000        0,037        0,810        0,031
──────────────────────────────────────────────────────────────────────────────
Observations                        179          161          129          176
Sociétés (grappes)                   48           42           38           47
R² (année retirée)                0,301        0,027            .        0,025
Sd. résiduelle                    15,62        73,69        46,38        53,44
Effets fixes d’année                oui          oui          oui          oui
──────────────────────────────────────────────────────────────────────────────
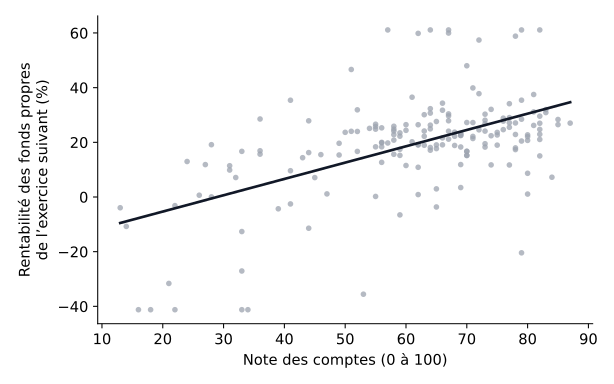
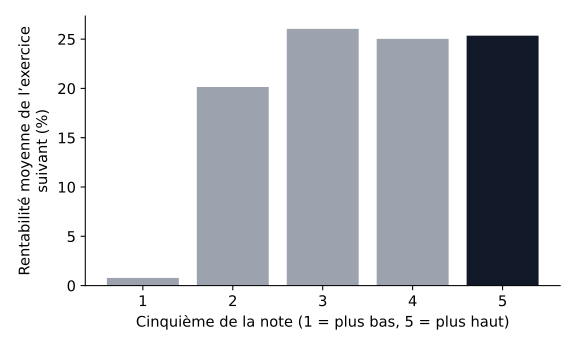
La note est liée à la rentabilité de l’exercice suivant : +6,01 points pour +10 points de note, P>|t| 0,000, bootstrap 0,000, Holm 0,001. Elle n’est liée ni à la baisse du dividende ni à l’évolution du bénéfice. Pour le cours, l’effet apparent (−4,84 point à 12 mois) devient p = 0,089 au bootstrap et 0,267 après Holm.
                 pente         N
────────────────────────────────
2021              3,03        48
2022              3,43        48
2023             −2,93        48
2024            −24,20        48
────────────────────────────────
Moyenne −5,17   Sd. 6,51   t(3) = −0,79   P>|t| = 0,485
Apport de la note
La rentabilité d’une année ressemble beaucoup à celle de l’année précédente : la note peut sembler prédictive parce qu’elle reprend cette persistance. On teste donc si elle ajoute quelque chose une fois la rentabilité actuelle connue.
                                       (1)               (2)
roe_suiv.
────────────────────────────────────────────────────────────
rentabilité actuelle                  0,75              0,68
  Sd.                               (0,09)            (0,16)
note (+10 points)                                       0,99
  Sd.                                                 (1,26)
  P>|t|                                                0,435
  p bootstrap                                          0,466
  [IC 95 %]                                   [−1,54 ; 3,53]
────────────────────────────────────────────────────────────
Observations                           175               175
R²                                  0,4832            0,4872
R² ajusté                           0,4710            0,4720
────────────────────────────────────────────────────────────
Le R² passe de 0,483 à 0,487, l’intervalle de la note contient zéro (bootstrap 0,466) : ce que la note sait de l’exercice suivant, la rentabilité actuelle le savait déjà.
Les cinq critères
Régression de la rentabilité de l’exercice suivant sur les cinq critères à la fois (exercices 2023 et 2024). VIF : facteur d’inflation de variance, signe de redondance entre critères au-delà de 5.
rentabilité N+1     Coef.      Sd.        t    P>|t|  [IC 95 %         ]      VIF
─────────────────────────────────────────────────────────────────────────────────
rentabilité          2,39     0,95     2,51    0,016      0,47      4,31     1,78
croissance           0,36     0,89     0,40    0,692     −1,44      2,15     1,27
solidité            −0,79     0,88    −0,90    0,374     −2,55      0,98     1,33
prix payé            0,65     1,49     0,44    0,664     −2,34      3,64     1,89
dividende            2,45     1,90     1,29    0,204     −1,37      6,27     1,35
─────────────────────────────────────────────────────────────────────────────────
Observations 89   R² 0,363   R² ajusté 0,299
Test conjoint des cinq critères : F = 11,81, P > F = 0,000
Coefficients : effet de +10 points du critère. Effets fixes d’année, erreurs groupées par société.
                rentabilité   croissance     solidité    prix payé    dividende
───────────────────────────────────────────────────────────────────────────────
rentabilité            1,00
croissance             0,36         1,00
solidité               0,41        −0,04         1,00
prix payé              0,44         0,40         0,22         1,00
dividende              0,16         0,12         0,27         0,29         1,00
Robustesse
Variante (note, +10 points)                             Coef.      Sd.    P>|t|        N
────────────────────────────────────────────────────────────────────────────────────────
Banques seules                                           4,19     1,43    0,010       64
Hors banques                                             6,81     1,47    0,000      115
Exerc. 2023 et 2024 (cinq critères disponibles)          5,79     1,58    0,001       87
Exerc. 2021 et 2022                                      6,14     1,23    0,000       92
Note sans le critère « Prix payé » (2023 et 2024)        5,48     1,08    0,000      179
Sans winsorisation                                       7,24     1,71    0,000      179
────────────────────────────────────────────────────────────────────────────────────────
Les pondérations
Les anciens poids (rentabilité 25, croissance 20, solidité 20, prix payé 25, dividende 10) étaient un choix éditorial. Que peuvent en dire les données ? Plusieurs pondérations ont été comparées, sur 89 observations (exercices 2023 et 2024).
                       Coef.         Sd.     retrait   poids MCO poids Bayes
────────────────────────────────────────────────────────────────────────────
rentabilité            0,239       0,095        0,76          41          28
croissance             0,036       0,089        0,74           6          18
solidité              −0,079       0,088        0,73           0          11
prix payé              0,065       0,149        0,89          11          20
dividende              0,245       0,190        0,93          42          23
────────────────────────────────────────────────────────────────────────────
poids MCO : coefficients négatifs ramenés à 0, puis normalisés.
poids Bayes : coefficients rapprochés de leur moyenne selon leur imprécision (Bayes empirique, tau² = 0,0028), puis normalisés.
Pondération                                   rho    écart             [IC 95 %]
────────────────────────────────────────────────────────────────────────────────
Ancien (25, 20, 20, 25, 10)                 0,338     réf.
Égal (20 chacun), retenu                    0,348    0,012      [−0,026 ; 0,053]
Rentabilité 50 (50, 20, 15, 10, 5)          0,399    0,077      [−0,001 ; 0,172]
Rentabilité seule                           0,418    0,099      [−0,037 ; 0,264]
MCO positifs (appris hors pli)              0,389        .
Bayes empirique (appris hors pli)           0,347        .
────────────────────────────────────────────────────────────────────────────────
Ancien (25, 20, 20, 25, 10)                  0,230
Égal (20 chacun), retenu                     0,237
Rentabilité 50 (50, 20, 15, 10, 5)           0,201
Rentabilité seule                            0,185
Lecture : les poids estimés sur la rentabilité de l’année suivante donnent beaucoup à la rentabilité parce que c’est, en partie, ce qu’on cherche à prédire. L’avantage de « rentabilité 50 » disparaît quand on regarde les pertes, et son intervalle touche zéro. Les poids de Bayes empirique tombent près de l’égalité : les données ne distinguent pas nettement les critères entre eux. Aucune pondération n’est démontrée meilleure sur plusieurs résultats à la fois.
Décision : poids égaux, 20 % chacun. Faute de preuve qu’un critère mérite plus, nous n’en favorisons aucun. Les poids égaux classent aussi bien que les anciens (écart 0,012, intervalle à 95 % de −0,026 à 0,053). Si de nouvelles années de comptes montrent un critère nettement meilleur sur plusieurs résultats, la décision sera revue ici.
Poids affichés et influence réelle
Les cinq critères pèsent 20 % chacun, mais un poids n’est pas une influence : un critère qui varie beaucoup d’une société à l’autre fait davantage bouger la note finale qu’un critère qui varie peu. L’influence réelle d’un critère est sa part de la variance de la note ; la stabilité se mesure en tirant des milliers de pondérations voisines.
                            poids affiché       écart type    corr. de rang influence réelle    rho sans elle     bande change
──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
rentabilité                          20 %             30,0             0,84             30 %            0,928             18 %
croissance                           20 %             22,6             0,60             16 %            0,950             18 %
solidité                             20 %             22,2             0,49             12 %            0,947             22 %
prix payé                            20 %             28,7             0,70             29 %            0,969             22 %
dividende                            20 %             18,7             0,44             14 %            0,982             16 %
──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Observations : 96. Influence réelle = poids × covariance(composante, score) ÷ variance du score (somme : 100 %).
« rho sans elle » : corrélation de rang du score avec le score recalculé sans cette composante.
                                              rho moyen      rho (5 % pires)         bande change  bande change (95 %)     2 bandes ou plus
───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Poids voisins (concentration 30)                  0,978                0,948                 13 %                 25 %                0,0 %
Poids quelconques (uniforme)                      0,911                0,786                 30 %                 48 %                1,3 %
───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
5000 tirages de poids. « bande change » : part des observations qui changent de verdict.
Lecture : avec des poids égaux, la rentabilité (30 %) et le prix payé (29 %) portent à eux deux plus de la moitié de la note. Le classement des sociétés reste très stable si l’on change les poids (corrélation de rang 0,98 avec des poids voisins), mais environ 13 % des sociétés changent de verdict, car ce sont les seuils des verdicts qui sont sensibles, pas l’ordre. Les verdicts proches d’un seuil sont donc à lire comme des zones, pas comme des frontières nettes.
Graphiques
Limites
- Quatre exercices et environ 45 sociétés par année : les intervalles sont larges, les sous-groupes fragiles.
- Les comptes sont ceux de la base en 2026 (SikaFinance), pas ceux publiés à l’époque.
- Seules les 48 sociétés cotées aujourd’hui sont étudiées : biais de survie.
- Rendements hors dividendes. Date de publication des comptes supposée au 30 juin.
- La note et la rentabilité qu’on veut prédire viennent des mêmes comptes : corrélation en partie mécanique.
- Les poids égaux sont un choix de prudence, pas une optimisation : ajuster les poids sur ces données reviendrait à régler le modèle sur la réponse qu’on veut mesurer.
- Corrélation n’est pas causalité. Un résultat passé ne garantit pas un résultat futur.
Reproduire
node scripts/calibration/fetch.mjs donnees
node scripts/calibration/accounts_panel.mjs donnees panel.csv
python scripts/calibration/accounts_tests.py panel.csv public/tests/comptes
Python avec pandas, statsmodels, scipy, matplotlib. Résultats bruts : results.json. Voir aussi les tests des scores de la Fiche, la méthodologie et la calibration des indicateurs de marché. Information générale, pas un conseil en investissement.